Fable 5.1 işi yapmasın, ekibi yönetsin
Şunu bi netleştirelim: Fable 5.1 daha iyi bir sohbet botu değil, saatlerce tek başına çalışabilen bir operatör. O yüzden ondan alacağınız en büyük verim, onu her işi kendisi yapan kişi olarak değil, işi yapan sistemin başına koyduğunuzda geliyor.
Önce sayılara bi tur bakalım
Anthropic'in yayınladığı değerlendirmelerde Fable 5.1, agentic bilimsel araştırmada Fable 5'in iki katından fazlasını yapıyor (Terminal-Bench-Science'ta %24.7'den %52.6'ya). İş otomasyonunda (AutomationBench) %17.1'den %31.4'e çıkıyor, yani neredeyse iki kat. CursorBench'te %73.4.
Kodlama, otomasyon, computer use ve bilgi işi testlerinin çoğunda Fable 5, Opus 5 ve GPT-5.6 Sol'un önünde. Ama dediğim gibi, sayılar hikâyenin en az ilginç kısmı.
Neyi farklı yapıyor
Uzun işte ipin ucunu kaçırmıyor. Ramp ekibi 38 saatlik, gözetimsiz bir machine learning koşusu anlatıyor. Fable önceki kötü bir sonucu teşhis etmiş, düzeltmiş, altı deneyi paralel başlatmış ve bulgularla bir sonraki adımları getirmiş. 1M token'lık context tek başına mesele değil. Mesele, o context'in içinde hâlâ doğru kararlar verebilmesi.
Hızlı yamayı değil, kök nedeni arıyor. Millennium ekibi ona milyonda bir tekrarlanan ve dört beş yıldır kimsenin çözemediği bir crash vermiş. Fable dışarıdan gelen bir kütüphaneyi disassemble etmiş, core dump'la eşleştirmiş ve gerçek bug'ı bulmuş. Fable 5 dahil denedikleri diğer modeller kaçırmış.
Görüyor, yapıyor, kontrol ediyor. Ekran görüntüsü, grafik, PDF okuyor; tarayıcı kullanıyor. Önemli olan şu: gördüğünü sadece tarif etmiyor, kendi işini referansla karşılaştırmak için kullanıyor.
Nutuk değil, iş teslim ediyor. Bir klasör doküman verip yatırım memosu, sunum ya da prototip istediğinde, sana nasıl yapılacağını anlatmak yerine dosyanın kendisini getirme ihtimali çok daha yüksek. Bir MongoDB mühendisi üç günlük bir koşu anlatıyor: model mevcut servisleri araştırmış, sistemi tasarlamış, aşama aşama gözetimsiz kurmuş ve her aşamanın çalıştığına dair kanıtla dönmüş.
Kokpit: gereken birkaç komut
yapmdayısanız eğer önce Claude Code'u güncelle. fable alias'ı 2.1.257 ve sonrasında Fable 5.1'e gidiyor (rehber 2.1.255 diyor, changelog'a göre doğrusu 2.1.257). Sonra:
/model fable
/effort high
high ciddi işler için makul varsayılan. Ucuz ve hızlı turlar için medium, gerçekten zor problemde xhigh ya da max. Fable'da adaptive thinking hep açık, o yüzden asıl ayar effort.
Geri kalanı:
/plan ya da Shift+Tab — dosyalara dokunmadan önce incelesin, plan çıkarsın
/goal — test edilebilir bir koşul sağlanana kadar turlar boyunca çalışsın
/loop — bir prompt'u belli aralıkla tekrar koşsun
/tasks — arka plandaki agent'lar ne yapıyor
/context — context'i ne yiyor
Asıl mesele: Fable'ı orchestrator yap
En büyük sıçrama bir rol değişikliği. Fable'a her klavye işini verme. İşi tanımlasın, temiz şeritlere bölsün, bu şeritleri daha ucuz agent'lara dağıtsın ve dönen işi yargılasın.
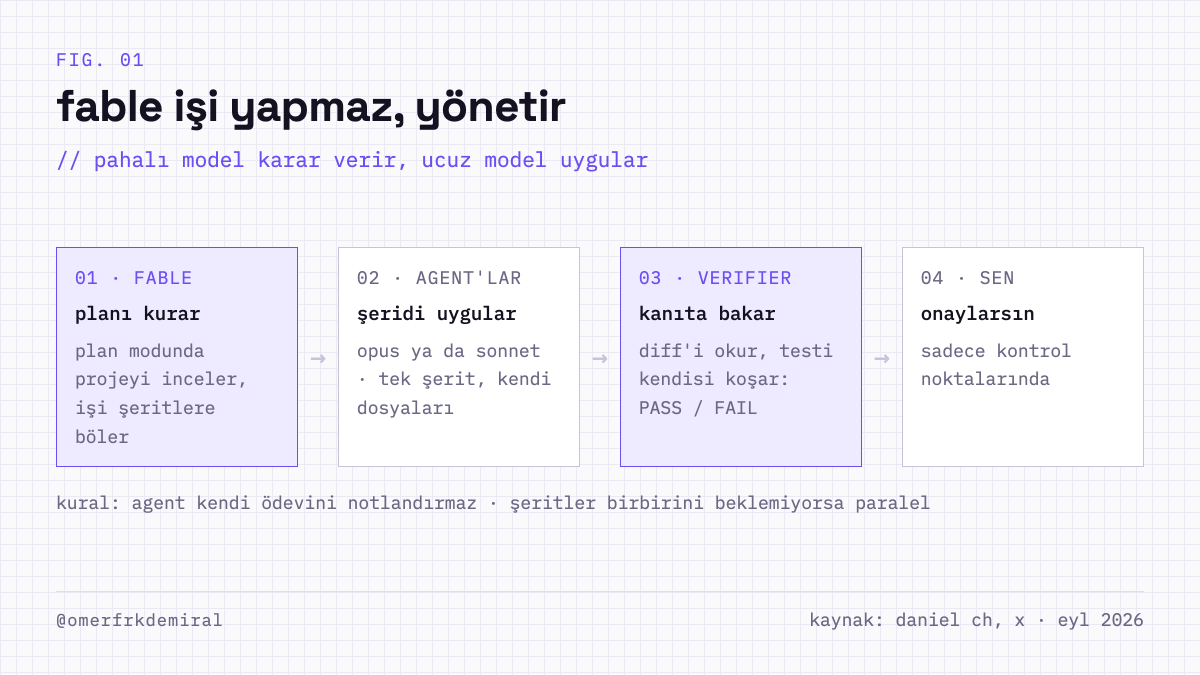
Kurulum dört parçaya ayırdım:
- Fable planı kurar. Plan modunda projeyi inceler, sonra değişiklik önerir.
- Agent'lar uygular. Opus ya da Sonnet subagent'ları, her biri tek, sınırları belli bir şerit.
- Ayrı bir verifier kontrol eder. Agent kendi ödevini notlandırmaz. Taze bir agent planı okur, diff'e bakar, testleri kendisi koşar: geçer ya da somut bir hatayla geri döner.
- Sen sadece kontrol noktalarında girersin. Planı onayla, önemli tercihlere bak, sonunda kanıtı incele. Her komutu izlemen gerekmiyor.
Mantığı basit: pahalı model token'ını mimariye, önceliklendirmeye ve yargıya harcıyor, ucuz modeller sınırları belli uygulamaya.
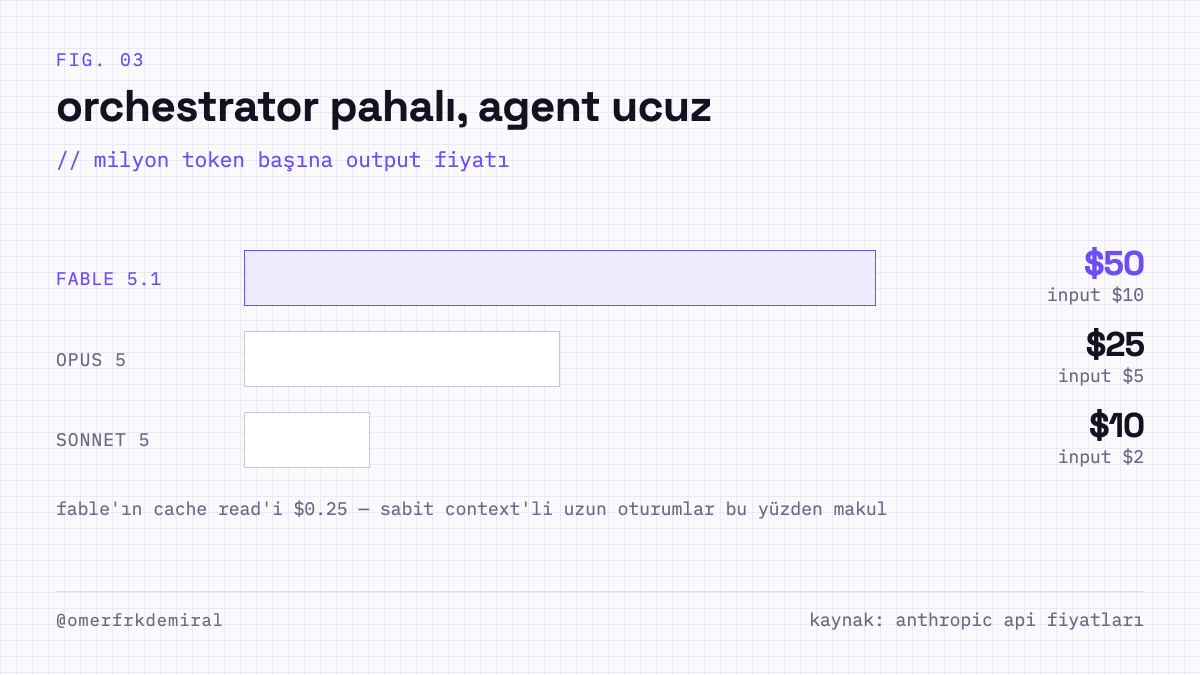
Fiyat farkı bunu anlamlı kılıyor. Fable 5.1 milyon token başına input'ta $10, output'ta $50. Opus 5 bunun yarısı, Sonnet 5 beşte biri. Fable'ın cache read'i de $0.25'e inmiş, yani sabit bir proje context'iyle uzun oturumlar artık çok daha makul.
Paralelliği gösteriş için yapma. Aynı dosyaları düzenleyen beş agent, beş fatura ve bir merge problemi demek.
Paralel çalıştırmaya değer olanlar: araştırma, izole modüller, testler, dokümantasyon. Yani birbirini beklemeden bitebilen şeritler.
Agentlarını kur
Özel bir agent, .claude/agents/ altında bir Markdown dosyasından ibaret. İki tane yeter. İlki uygulayıcı:
---
name: implementation-worker
description: Onaylanmış plandan tek, izole bir aşamayı uygular. Sadece aşamanın kendi dosyaları varsa kullan.
model: opus
tools: Read, Grep, Glob, Edit, Write, Bash
maxTurns: 25
---
Sadece sana verilen aşamadan sorumlusun.
Düzenlemeden önce şeridindeki dosyaları ve kabul kriterlerini belirle.
Başka agent'ın dosyasına dokunma. En küçük tam çözümü yaz, ilgili testleri koş.
Dön: değişen dosyalar, koşulan kontroller ve gerçek çıktıları, hâlâ belirsiz olanlar.
Bu koşudan kanıt olmadan başarı ilan etme.
İkincisi, asıl önemli olan verifier:
---
name: verifier
description: Biten bir aşamayı planına ve kabul kriterlerine göre bağımsız doğrular. Her uygulama aşamasından sonra kullan.
model: opus
tools: Read, Grep, Glob, Bash
maxTurns: 15
---
Uygulama özetini güvenilmez bir iddia olarak ele al.
Planı oku, gerçek diff'i incele, testleri kendin koş.
Doğruluk, regresyon, kapsam ve her kabul kriterine bak. PASS ya da FAIL dön.
Her hata için kanıtı ve gereken en küçük düzeltmeyi yaz.
Notlandırdığın koda asla dokunma.
Verifier'da Edit ve Write yok, bu bilinçli. Taze göz, yazarın kanıksadığı şeyi yakalar. Hemen kontrol edilen bir aşama, üstüne dört aşama daha kurulduktan sonra bulunan bir hatadan çok daha ucuz.
Rotayı değil, varış noktasını tarif et
Prompt tavsiyelerinin çoğu, zayıf modellerin yolunu kaybetmesini engellemek için yazıldı. Uzun prosedürler, katı adım listeleri, dev kural blokları. Fable 5.1'de bu iskele, modeli kendi bulacağından daha kötü bir yola zorlayabiliyor.
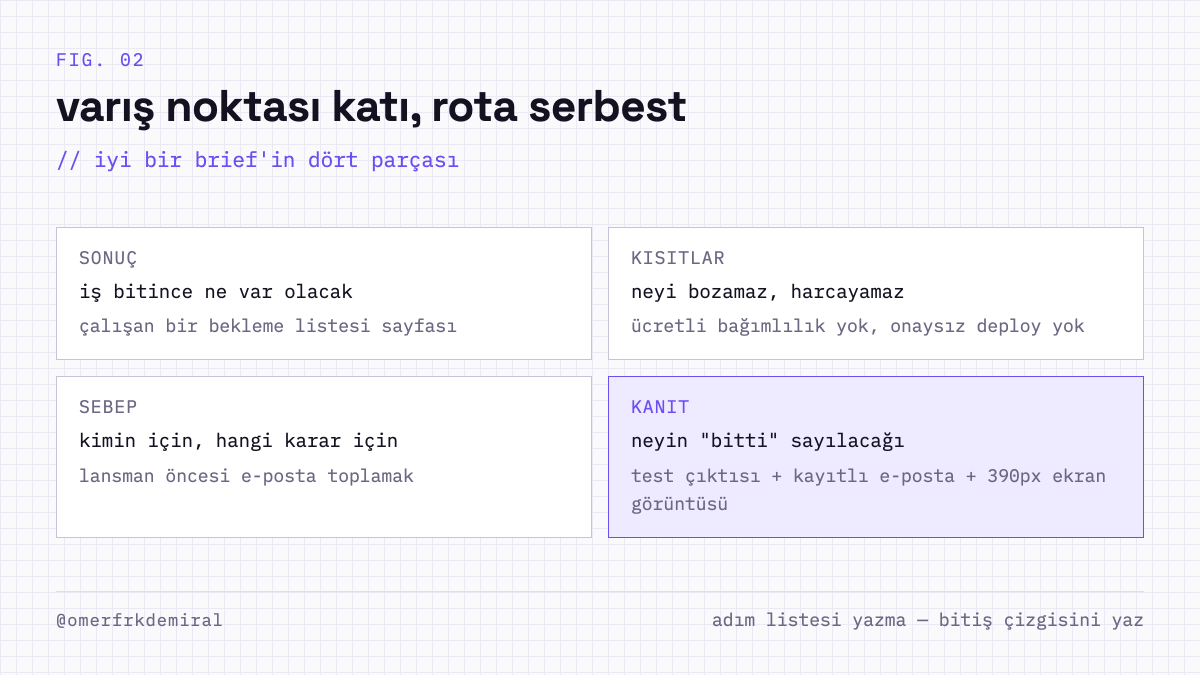
Dört şey ver: sonuç, kısıtlar, sebep ve kanıt. En çok farkı sonuncusu yaratıyor. "Checkout'u çalıştır" dersen makul görünen bir iddia alırsın. "Sandbox'ta test satın alması yap ve oluşan sipariş satırını göster" dersen, lafla geçiştiremeyeceği bir bitiş çizgisi vermiş olursun.
İki küçük not daha. Gizli düşünce zinciri gösterisi isteme; plan, önemli kararlar, kanıt ve kalan belirsizliği iste. Bütçenin bittiğini de sürekli hatırlatma. Sınırı sisteme koy: agent turlarını sınırla, harcama limitini belirle, limite gelince ne yapacağını söyle.
CLAUDE.md'yi hafif tut
CLAUDE.md her oturumun başında yükleniyor. Faydalı, ama alakasız her satır gelecekteki her işten vergi alıyor demek. Anthropic dosya başına 200 satırın altını öneriyor. Pratikte çok daha kısası yetiyor.
Üç bölüm çoğu projeye yeter: proje ne, iş nasıl doğrulanır, sürekli neyi yanlış yapıyor. Ara sıra gereken prosedürler skill'e, belli dosyalara özel kurallar path-scoped rule'lara, tarihçe dokümantasyona.
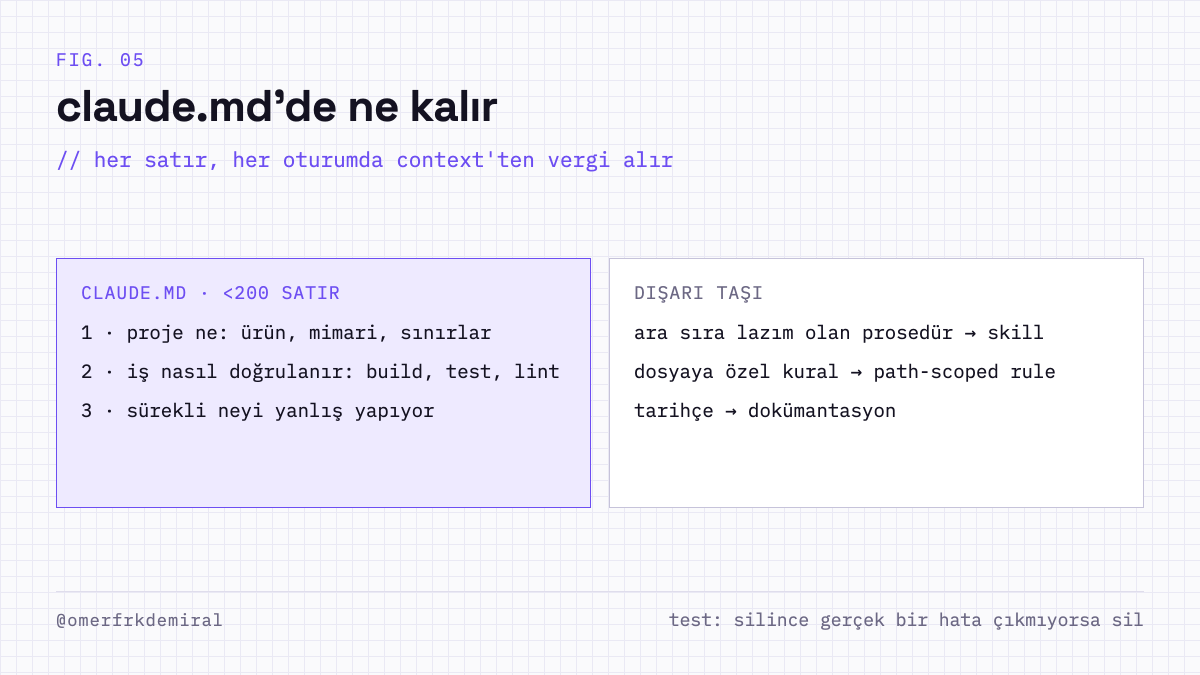
Bu akşam CLAUDE.md'ni aç ve her satıra şunu sor: silersem gerçek bir hata çıkar mı? Çıkmıyorsa sil.
Goal ve loop: sohbetten sürece
Fable'ın sohbet olmaktan çıkıp sen başka iş yaparken ilerleyen bir sürece dönüştüğü yer burası.
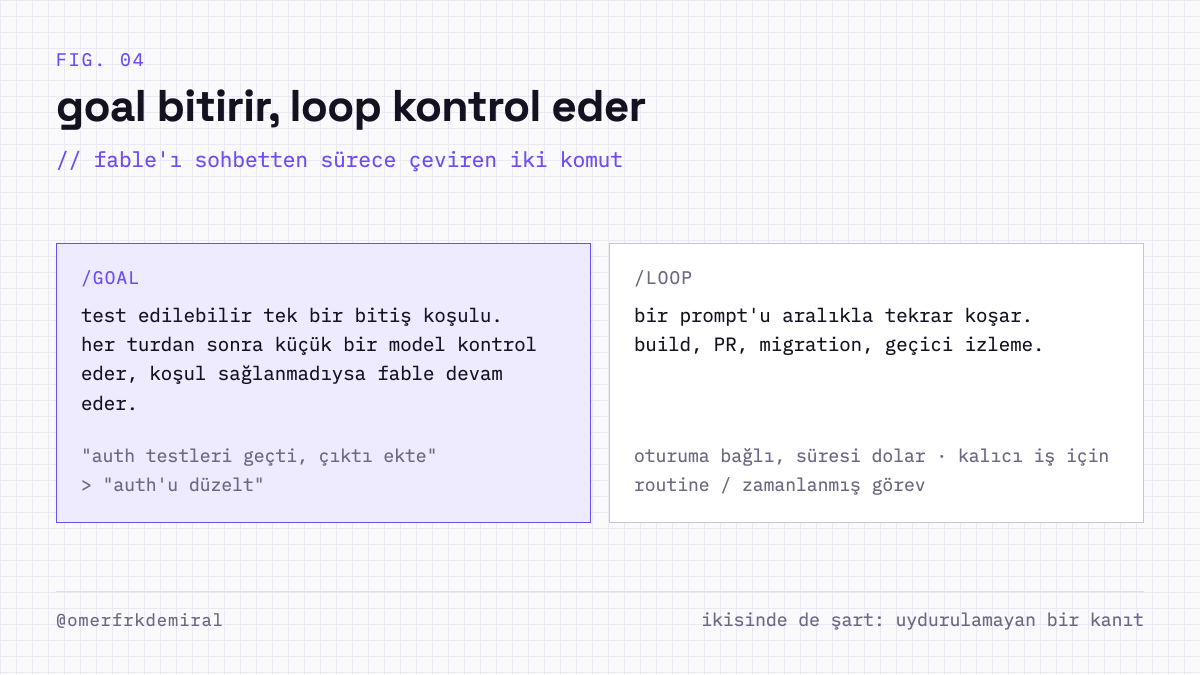
/goal oturuma test edilebilir tek bir bitiş koşulu veriyor. Her turdan sonra ayrı, küçük bir model koşulun sağlanıp sağlanmadığına bakıyor. Sağlanmadıysa Fable kontrolü sana vermek yerine yeni bir tura başlıyor. Koşul sağlanınca, imkânsızlaşınca, kurtarılamaz bir hata çıkınca ya da sen temizleyince bitiyor.
İşin zanaatı, uyduramayacağı bir bitiş çizgisi yazmakta:
- Gözlemlenebilir kanıt iste. "Tüm auth testleri geçti ve çıktı ekte", "auth'u düzelt"ten güçlü.
- Başarısızlık yolunu tanımla. Gerçek bir engel varsa ilerleme uydurmak yerine engeli ve kanıtını raporlasın.
- Riskli yerleri sınırla. Agent'lara maxTurns, ücretli servislere harcama limiti, deploy ve production verisine net sınır.
- Tek bir dürüstlük kuralı. Her ilerleme iddiası bu koşuda üretilmiş ya da incelenmiş bir sonuca dayanmalı.
Gözetimsiz auto mode'u sadece rahat olduğun sınırlar içinde kullan. Daha akıllı bir agent'ın, brief yanlışsa hasar alanı da daha büyük.
/loop ise bir prompt'u aralıkla tekrar koşuyor: /loop 15m deploy'u kontrol et, hata varsa incele gibi. Aralık vermezsen Claude ne zaman bakacağına kendi karar veriyor. Loop'lar oturuma bağlı ve süreleri doluyor. Build, PR, migration ve geçici izleme için ideal. Oturum ya da makine kapandıktan sonra da sürmesi gereken iş için kalıcı bir routine ya da zamanlanmış görev kullan.
Tek seferde gerçek bir proje
Örnek: çalışan bir bekleme listesi formu olan bir landing page. Proje değişse de sıra aynı.
1. Brief'i yaz. Tek mesaj: kim için, ne vaat ediyor, kısıtlar (babysit etmem gereken framework yok, ücretli bağımlılık yok, mobilde hızlı, onayımdan önce deploy yok) ve "bitti"nin tanımı: sayfa lokalde çalışıyor, test e-postası depoda görünüyor, 390px'te mobil düzen doğrulandı, sonuç test çıktısı ve ekran görüntüleriyle gösterildi.
2. Planı onayla. Shift+Tab ile plan moduna gir. Fikir henüz netleşmediyse Matt Pocock'un skill koleksiyonu işe yarıyor: /plugin install mattpocock-skills, bir kere /setup-matt-pocock-skills, sonra /grill-with-docs ile fikri sorgulatıp spec'e çevir. Planı oku, gereksiz özellikleri kes, her aşamanın gözlemlenebilir bir geçme koşulu olduğundan emin ol.
3. Takımı çalıştır. Fable ilk izole aşamayı agent'a verir, verifier diff'i ve test çıktısını kontrol eder. Bağımlı aşama ancak önceki geçince başlar. Terminalden kalkabilirsin, merak edersen /tasks.
4. Bitiş çizgisini koy.
/goal sayfa lokalde çalışıyor, form bir test kaydını saklıyor ve düzen 390px'te çalışıyor; kanıt: gerçek test çıktısı, saklanan kayıt ve güncel ekran görüntüsü. Gerçek bir engel bunu imkânsız kılarsa dur ve başarı iddia etmek yerine kanıtı raporla.5. Sonuca kullanıcı gibi bak. Modelin yöneticisi gibi değil. Gördüğün değişiklikleri iste, son bir bağımsız doğrulama turu koştur, kanıt brief'le eşleşince ship et.
İlk seferde abartılı gelecek. İkincide, ertelediğin projelerin çoğunda aynı sıranın işlediğini fark edeceksin.
Nereye yöneltmeli
Modelin fiyatını hak eden beş iş tipi:
- Kimsenin istemediği kod tabanı işi. Üç hafta tahmin edilen migration, nadir production hatası, sekiz servise yayılmış performans sorunu.
- Karar kalitesinde araştırma. Agent'lar birincil kaynaklardan paralel toplar, şüpheci bir reviewer her önemli iddiaya saldırır, orchestrator ayakta kalanı memoya çevirir.
- İş operasyonları. Veri mutabakatı, anomali inceleme, rapor hazırlama, operasyonel backlog. AutomationBench'teki sıçrama en net pratik kazanım.
- Referansa göre ürün işi. İstediğin deneyimin ekran görüntülerini ve çalışan uygulamayı ver; uygular, açar, karşılaştırır, görünür fark kapanana kadar devam eder. Zevki sen getiriyorsun, göz ve sabrı o.
- Birikerek büyüyen bir bilgi sistemi. Dağınık dokümanları bağlantılı, bakımı yapılan tek bir doğruluk kaynağına çevirmek. Sonraki her agent daha akıllı başlıyor.
Bugün yapılacaklar
- Claude Code'u güncelle, /model fable ve /effort high ayarla
- .claude/agents/ altına bir implementation-worker ve bir verifier ekle
- CLAUDE.md'ni üç bölüme indir, gerisini skill ve rule'lara taşı
- Bir sonraki işin brief'ine "kanıt" satırı ekle: neyi görünce bitti diyeceksin
- Ertelediğin küçük bir işi /goal ile, gözlemlenebilir bir koşulla dene
- Paralel çalıştırmadan önce şeritlerin gerçekten bağımsız olup olmadığına baks
Daniel Ch'in uzun rehberinden bunu çıkardım. yanlış ya da gereksiz bulduğum yerleri düzelttim veya attım.