Graph engineering: ne demek, nasıl kurulur
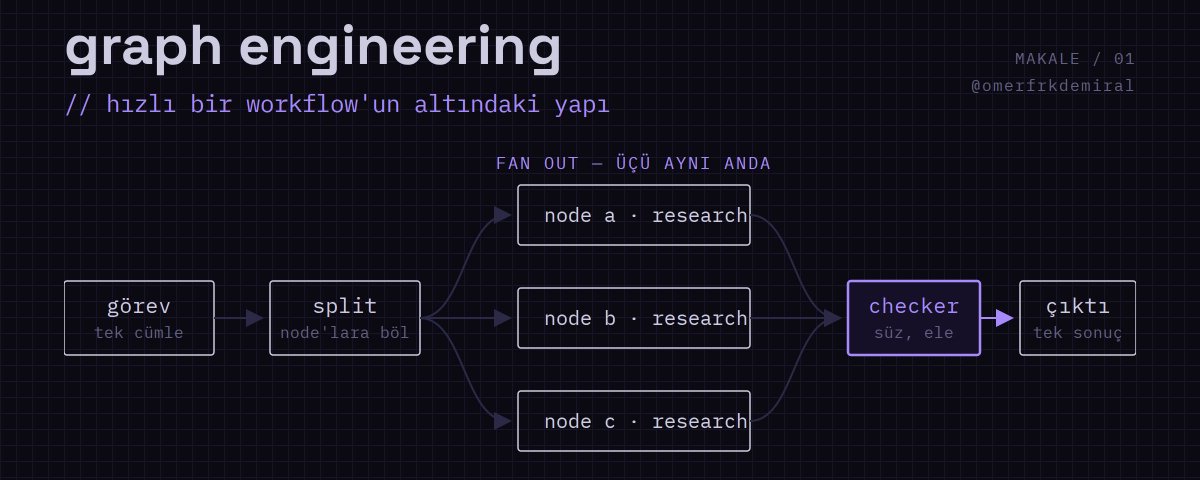
Birkaç ay önce herkes loop'ları konuşuyordu. Sonra timeline'a graph'lar düştü ve loop'lar bir gecede eski konu oldu.
Konuşulanların çoğunun bir sorunu var. Ya işe yaramayacak kadar muğlak, ya takip edilemeyecek kadar teknik. Kimse graph'ın ne olduğunu söylemeden "hadi graph kur" diyor.
Bu yazının sonunda şunlar elinde olacak: graph'ın gerçekte ne olduğu, şu anki workflow'unun içinde saklı duran graph'ı nasıl bulacağın, bu yapıyı işe yarar kılan tek desen, nerede sessizce bozulduğu ve Claude Code ile bunu gerçekten nasıl çalıştıracağın.
graph gerçekte nedir
Çoğu insan "graph" deyince çubuklu bir grafik düşünüyor. Konu o değil.
AI tarafında graph, hangi işlerin yapılması gerektiğini ve her birinin neye bağımlı olduğunu gösteren bir haritadır. Tamamı iki parçadan oluşur.
Node bir iş birimidir. Bir agent, bir görev, giren tek bir şey ve çıkan tek bir şey. "Bu konuyu araştır, sonra özet çıkar, bir de kaynakları kontrol et" bir node değildir. Bunlardan sadece biri node'dur. İş tanımı ne kadar küçük ve netse node o kadar kullanışlı olur.
Edge bir bağımlılıktır. İkinci node, birincinin ürettiği şeye gerçekten ihtiyaç duyuyorsa aralarında edge vardır. "Bu ikisi arka arkaya oluyor" yetmez. Birinin çıktısı diğerinin girdisi olacak.
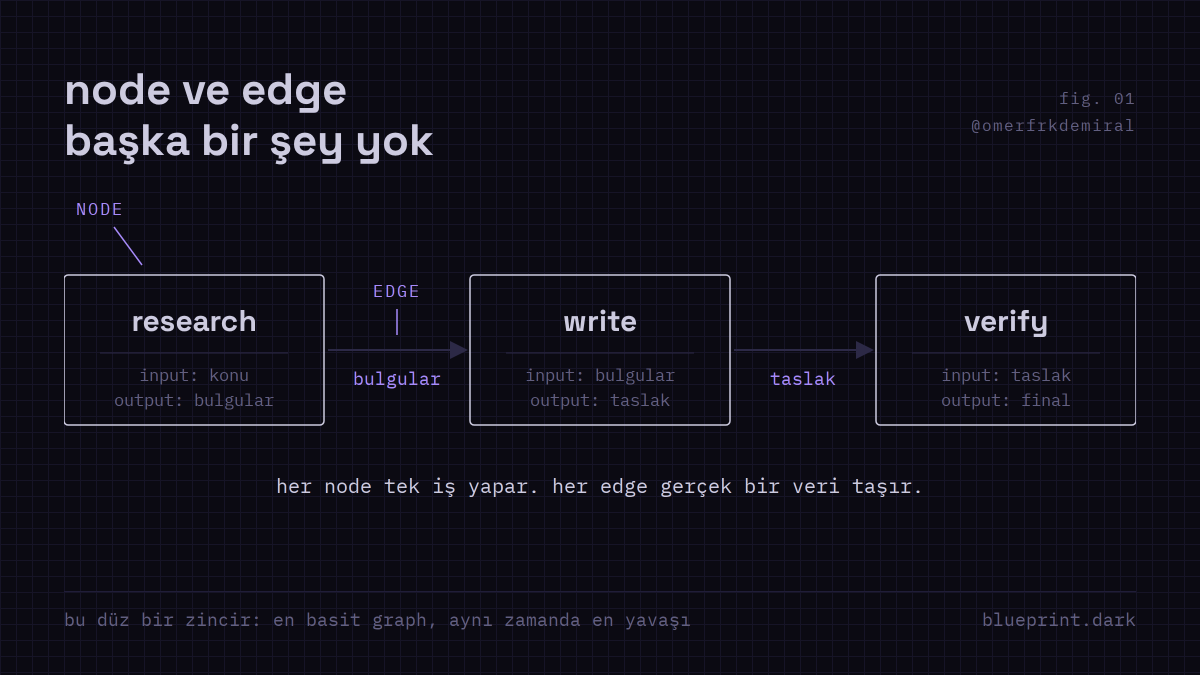
Node'lar işi yapar, edge'ler aralarında taşınan şeyi taşır. Graph engineering'in geri kalanı bu iki fikrin farklı ölçeklerde uygulanmasından ibaret.
zaten graph yazıyorsun
İlk duyulduğunda kaçırılan şey şu: bunu zaten yapıyorsun. Sadece kötü yapıyorsun.
"Şu konuyu araştır, bulduklarını özetle, özete dayanarak bir taslak yaz" yazdığında ortaya çıkan şey bir graph. Tek sıra halinde, dallanmayan bir zincir. Her adım kendinden öncekinin bitmesini bekliyor.
Doğru çalışır. Yavaş da çalışır ve kolay kırılır. Özet adımı kullanılamaz bir şey üretirse taslak adımı da çöker. Araştırma uzun sürerse arkadaki her şey bekler. Zincirin yedeği yok, esnekliği yok. En basit graph biçimidir, basit olması verimli olduğu anlamına gelmez.
Graph engineering'in ilk hamlesi yeni bir şey öğrenmek değil. Elindekine bakıp şunu sormak: her adım gerçekten kendinden öncekini beklemek zorunda mı?
Çoğu zaman değil.
sahte edge testi
Workflow'unu graph olarak görebildiğin anda sıradaki hamle, orada olmaması gereken okları bulmak.
Adımları tek tek yaz. Her okun başına gel ve tek bir soru sor: bu adım öncekinin ürettiği şeyi gerçekten kullanıyor mu? "Ondan sonra geliyor mu" değil. Verisini alıyor mu.
Cevap evetse edge gerçek, sıra kalsın. Hayırsa orada edge yok. O iki iş birbiriyle ilgisiz ve aradaki bekleme tamamen israf.
Basit bir örnek: "A dosyasını bug'lar için incele, sonra B dosyasını incele." Bir sıra gibi okunuyor. Ama B'nin incelemesi A'nın döndürdüğü hiçbir şeye bakmıyor. Arka arkaya çalışmalarının tek sebebi, senin onları o sırayla yazmış olman. Aynı anda çalıştırdığında iş, yavaş olanın süresinde biter. İkisinin toplamında değil.
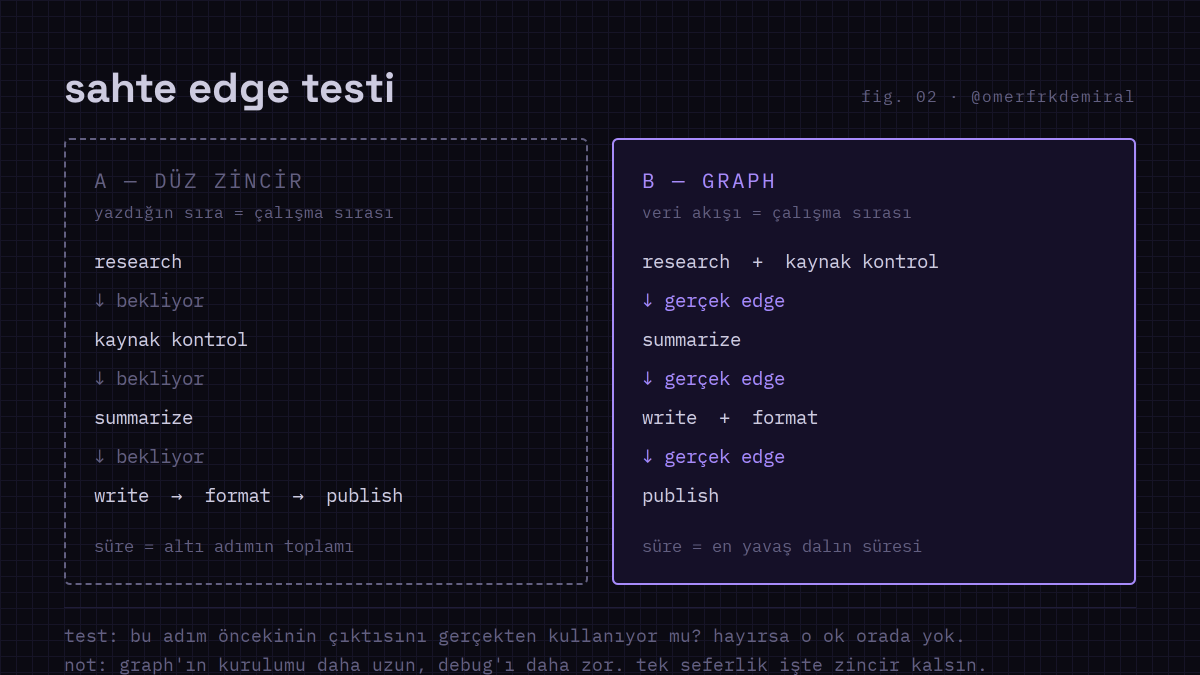
Testi beş dakikada herhangi bir workflow'a uygulayabilirsin:
- Her adımı bir kutu olarak yaz
- Ardışık her kutu çiftinin arasına ok çiz
- Her ok için sor: A'dan çıkan veri gerçekten B'ye giriyor mu
- Giriyorsa oku bırak, bu gerçek bir bağımlılık
- Girmiyorsa oku sil, bu bir sahte edge
- Gelen oku olmayan her şey en baştan başlayabilir
- Giden oku olmayan her şey nihai çıktıdır
Çizdiğin hemen her workflow'da iki üç sahte edge çıkar. Her biri bedavaya verdiğin zaman.
diamond deseni
Sahte edge'leri silmeye başlayınca bir desen diğerlerinden daha sık görünür. Adı diamond ve graph'ları kullanmaya değer kılan şey bu.
Fikir basit. Bir node birden fazla paralel node'a açılır. O paralel node'ların hepsi çıktılarını toplayan tek bir node'a bağlanır. Çizdiğinde eşkenar dörtgene benzer.
Pratikte şöyle görünür. Bir konuyu araştırıp yazacaksın. Düz hali: ara → kaynak 1'i oku → kaynak 2'yi oku → kaynak 3'ü oku → sentezle.
Diamond hali: ara → [kaynak 1 + kaynak 2 + kaynak 3 aynı anda] → sentezle.
Sentez node'u iki durumda da aynı girdiyi alır. Ama beklediği süre, en yavaş okumanın süresi kadar. Üçünün toplamı kadar değil.
Bu desen iki kurala dayanır. Birincisi, paralel node'lar gerçekten bağımsız olmalı. Gerçek gibi görünen sahte edge kalmamalı. İkincisi, birleştirme node'u hepsine gerçekten ihtiyaç duymalı. Sadece birine ihtiyacı varsa geri kalanı boşa yapılan iş.
İkisi de doğruysa diamond, bir workflow'un alabileceği en hızlı şekildir. Bir yerden toplayıp bir yerde birleştirdiğin her işte bu şekil var. Araştırma, code review, pazar analizi, hepsi aynı.
graph'lar nerede sessizce bozulur
Diamond teoride temiz. Pratikte iki noktada bozulur ve ikisini de fark etmek zor.
Birincisi bozuk çıktının gözden kaçması. Üç kaynak paralel çalışır ve biri çöp döndürür. Bir hallucination, boş sonuç, yanlış okunmuş dosya. Bu çıktı diğer iki temiz çıktının yanında doğrudan sentez node'una akar.
Sentez node'u girdilerinden birinin yanlış olduğunu bilmez. Hepsini birleştirir ve bozuk malzeme üzerine kurulmuş, kendinden emin bir cevap üretir. Hızı sağlayan paralel yapı, sorunu fark edeceğin doğal kontrol noktalarını da kaldırmıştır.
İkincisi hatanın izini kaybetmen. Düz zincirde kötü bir adım kötü bir çıktı verir ve bunu anında görürsün. Yolların birleştiği bir graph'ta kötü çıktı iyi çıktılarla karışır. Son node cevabını verdiğinde hasar seyrelmiş ve görünmez olmuştur.
İkisinin de çözümü aynı: checker node.
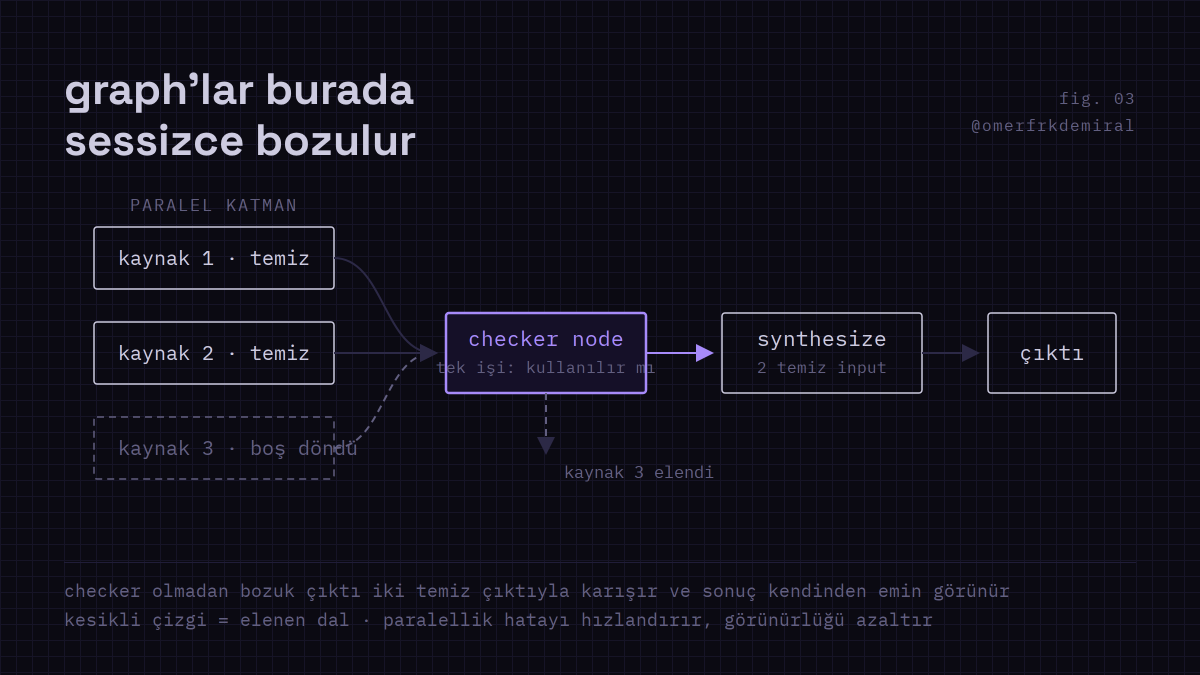
Checker node, paralel katman ile birleştirme noktası arasına oturur. Tek işi, her çıktıyı ilerlemeden önce değerlendirmek. Sentez yapmaz, yazmaz, asıl işin hiçbirine karışmaz. Sorduğu şey tek: bu çıktı kullanılabilir mi? Evetse geçirir. Hayırsa işaretler, tekrar dener veya bir sonraki adımı zehirlemeden düşürür.
Bir checker node'un yakalaması gereken beş şey:
- Boş veya null çıktılar
- Aynı anda doğru olamayacak şekilde birbiriyle çelişen çıktılar
- Asıl göreve göre konu dışı kalmış çıktılar
- Güvenilir sayılamayacak kadar düşük confidence sinyalleri
- Sentez node'unun parse etmesini bozacak format hataları
Checker node'u olmayan bir graph, yukarısındaki her şeyin çalıştığını varsayar. Bu varsayım tahmin ettiğinden daha sık tutmaz.
static ve dynamic
Buraya kadar olan her şey, graph'ın şeklini başlamadan önce bildiğini varsaydı. Node'ları tanımlıyorsun, edge'leri çiziyorsun, çalıştırıyorsun. Yapının değişmediği tekrar eden işlerde bu yeterli.
Gerçek işlerin bir kısmı bu kalıba oturmuyor. Bir araştırmaya başlıyorsun ve yarısında bir kaynağın üç ek arama gerektirdiğini görüyorsun. Code review'a başlıyorsun ve bir dosyanın diğerlerinden çok daha derin analiz istediği ortaya çıkıyor. İhtiyacın olan yapı başlangıçta bilinebilir değildi. İş yürürken netleşti.
Dynamic graph burada devreye giriyor. Yapı önden sabitlenmiyor, graph çalışırken kendini kuruyor. Bir node işini bitiriyor, bulduğuna bakıyor ve sıradaki node'ların ne olması gerektiğine karar veriyor.
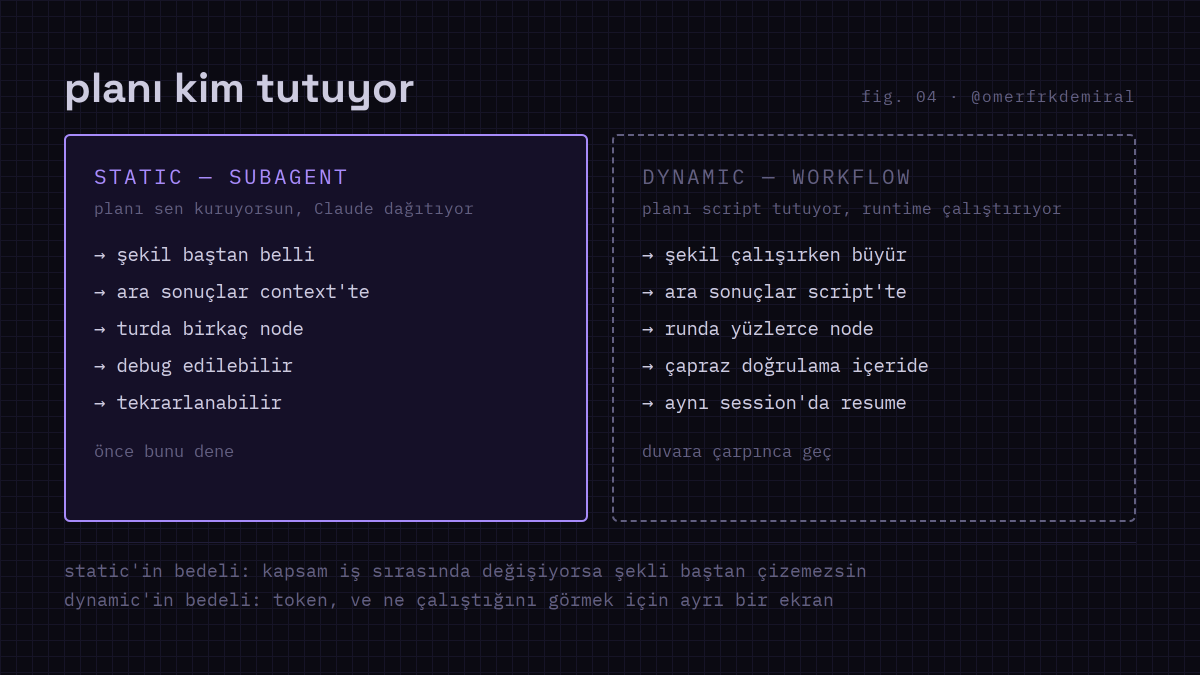
Fark pratikte hissediliyor. Static graph hızlı ve tahmin edilebilir. Ne çalışacağını, hangi sırayla çalışacağını ve ne kadar süreceğini biliyorsun. Dynamic graph esnek ve beklenmeyeni kaldırıyor. Karşılığında bir şey ters gittiğinde debug etmek zor, çünkü çalışan yapı senin çizdiğin yapı değil.
Hangisine ihtiyacın olduğunu baştan bilmek çok geri dönüş kurtarır:
- İş tekrar ediyorsa ve yapı her seferinde aynıysa static
- Hız ve öngörülebilirlik esneklikten önemliyse static
- İşin kapsamı yol boyunca bulduklarına bağlıysa dynamic
- Bazı node'ların çıktısına bakarak sıradakine karar vermesi gerekiyorsa dynamic
- Her zaman önce static dene, duvara çarpınca dynamic'e geç
- Tam olarak neyin neden çalıştığını denetlemen gereken işlerde dynamic kullanma
Dynamic graph gerektirdiğini düşündüğün workflow'ların çoğunun aslında daha iyi tasarlanmış bir static'e ihtiyacı var. Dynamic daha güçlü ve kontrolü daha zor. İkinci sırada dursun.
Claude Code'da nasıl kurulur
Buraya kadarki her şey zihinsel model. Claude'a çalıştırabileceği bir şey verdiğin an pratiğe dönüyor.
Burada bir yanlış bilgiyi düzeltmek gerekiyor. İnternette dolaşan bazı yazılar workflow: ve depends_on: alanları olan YAML benzeri bir söz dizimi gösteriyor ve bunun Claude Code'un anladığı bir format olduğunu söylüyor. Öyle bir format yok. Gerçekte iki mekanizma var ve ikisi de dokümante edilmiş durumda.
1. Subagent — static graph'ın karşılığı
Subagent, Claude'un ana session içinden başlattığı ayrı bir worker. Kendi context penceresi var, işini bağımsız yapıyor, bittiğinde özetini geri veriyor.
Static graph'ını burada kuruyorsun. Bağımsız node'ları paralel subagent'lere dağıtacağını prompt'ta açıkça söylüyorsun. Claude varsayılan olarak temkinli davranıp işi sıraya sokabiliyor, o yüzden paralelliği yazmak gerekiyor.
üç rakibi paralel subagent'lerle araştır. her subagent tek bir şirkete baksın:
fiyatlandırma, temel özellikler, son ürün değişiklikleri, kullanıcı yorumları.

üçü bittikten sonra ayrı bir subagent çıktıları kontrol etsin: boş, eksik veya
konu dışı olanı işaretlesin.

sadece kontrolden geçen çıktıları kullanarak karşılaştırma tablosunu yaz.
Buradaki yapı doğrudan diamond. Üç paralel node, bir checker, bir sentez. depends_on yazmana gerek yok, bağımlılığı cümleyle kuruyorsun. Node'a ne verildiğini ve neyi beklediğini yazdığın sürece sıra doğru kuruluyor.
2. Dynamic workflow — dynamic graph'ın karşılığı
Claude Code v2.1.154 ile gelen dynamic workflows, işin planını Claude'un context'inden çıkarıp bir script'e taşıyor. Claude senin tarif ettiğin iş için bir JavaScript orchestration script'i yazıyor, ayrı bir runtime bunu arka planda çalıştırıyor ve session'ın açık kalmaya devam ediyor.
Farkı şu: subagent'te planı Claude tur tur veriyor ve her ara sonuç context'e düşüyor. Workflow'da döngüyü, dallanmayı ve ara sonuçları script tutuyor. Claude'un context'ine sadece nihai cevap geliyor.
Tetiklemek için prompt'un içinde ultracode anahtar kelimesini kullanıyorsun. "workflow olarak çalıştır" gibi kendi cümlelerin de aynı işi görüyor. (v2.1.160 öncesinde anahtar kelime workflow idi.)
ultracode: src/routes/ altındaki her route handler'ı eksik auth kontrolü için
denetle ve her bulguyu raporlamadan önce karşıt bir agent'a doğrulat
Checker node burada mekanizmanın içine gömülü geliyor. Workflow, bağımsız agent'lara birbirlerinin bulgularını çürütmeye çalıştırabiliyor ve ancak ayakta kalan sonuçları raporluyor. Hazır gelen /deep-research komutu tam olarak bunu yapıyor: aramaları farklı açılara dağıtıyor, kaynakları çapraz kontrol ediyor, doğrulamadan geçemeyen iddiaları eleyip kaynaklı tek bir rapor veriyor.
Çalışan işi /workflows ekranından izliyorsun. Ekran her fazı, agent sayısını, token toplamını ve geçen süreyi gösteriyor. Bir agent'ı durdurabiliyor, duraklatıp devam ettirebiliyorsun. Bir run istediğini yaptıysa s ile script'i kaydedip kendi /komutun haline getiriyorsun.
Bilmen gereken sınırlar: aynı anda en fazla 16 agent, run başına toplam 1000 agent. Resume aynı session içinde çalışıyor, Claude Code'dan çıkarsan bir sonraki session baştan başlıyor. Ücretli planlarda açık, Pro'da /config üzerinden açman gerekiyor.
Maliyet tarafını da yazayım: bir workflow onlarca agent çalıştırdığı için aynı işi sohbet içinde yapmaktan belirgin şekilde daha fazla token harcıyor. Büyük bir işe girmeden önce dar bir dilimde denemek en sağlıklısı. Tüm repo yerine tek klasör, geniş soru yerine dar soru.
Resmi dokümantasyon: code.claude.com/docs/en/workflows ve code.claude.com/docs/en/agents
kopyalayıp uyarlayabileceğin prompt'lar
Çok dosyalı code review
auth.py, api.py ve db.py dosyalarını paralel subagent'lerle incele. her biri
kendi dosyasına baksın: güvenlik sorunları, edge case'ler, kod kalitesi.
somut ol, genel yorum yazma.

üçü bittiğinde bir subagent üç raporu birden okusun: birden fazla dosyada
tekrar eden sorunları ve dosyalar arası bağımlılıkları işaretlesin.

son olarak öncelik sırasına dizilmiş tek bir düzeltme listesi çıkar.
kritik olanlar üstte.
Makale araştırması ve taslak
[konu] için üç paralel araştırma çalıştır:
1. [kitle A] açısından: ne umursuyorlar, yaygın yanlış bilinen ne
2. [kitle B] açısından: aynı sorular
3. çoğu kişinin duymadığı üç somut örnek. genel vaka çalışması istemiyorum

üçü de bittikten sonra çıktıları kontrol et: boş veya konu dışı olan varsa
kullanma. kalanlarla iki kitleye de hitap eden bir taslak yaz ve
somut örneklerden biriyle aç.
Kontrolden geçene kadar döngü
ultracode: npx tsc --noEmit çalıştır ve raporlanan hataları düzeltmeye devam et.
type check geçene kadar veya üst üste iki turda ilerleme olmayana kadar sürdür.
Köşeli parantezleri değiştir. Node'ların içine ne koyduğundan bağımsız olarak yapı aynı kalıyor.
bir kere yaz, her session devralsın
İkiden fazla çalıştırdığın her workflow için son eklenecek şey bir CLAUDE.md girdisi. Bu, o projede graph'ları nasıl ele almasını istediğini söylüyor. Çıktı formatı, checker davranışı, hata durumunda ne yapılacağı. Her session'da bu bağlamı yeniden kurmuyorsun.
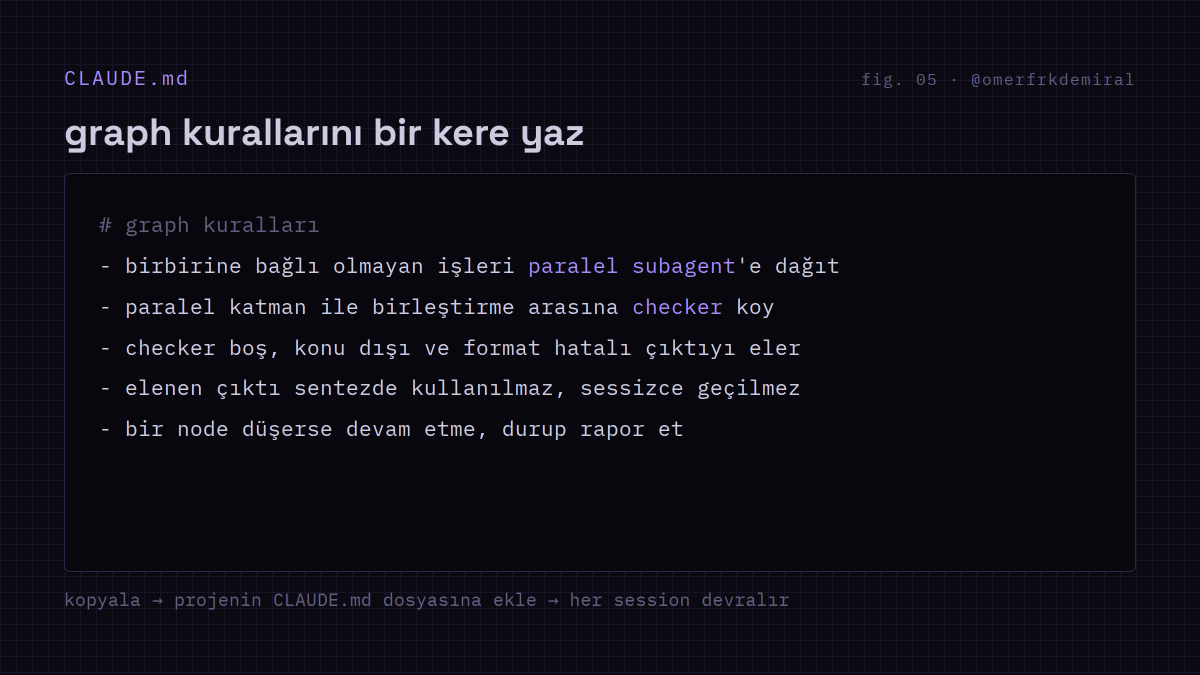
# graph kuralları

- birbirine bağlı olmayan işleri paralel subagent'e dağıt
- paralel katman ile birleştirme arasına checker koy
- checker boş, konu dışı ve format hatalı çıktıyı eler
- elenen çıktı sentezde kullanılmaz, sessizce geçilmez
- bir node düşerse devam etme, durup rapor et
- çıktı dosyaları /outputs altına, dosya adı node adı olsun
Tek dosya, bir kere. O projede çalıştırdığın her workflow bunu devralıyor.
graph düşünmeye başlayınca ne değişiyor
Yukarıdaki prompt'lar hemen işe yarıyor. Asıl değişim birkaç hafta sonra oluyor.
Bir işe yapılacaklar listesi olarak bakmayı bırakıp bağımlılıklar kümesi olarak bakmaya başlıyorsun. İlk soru "önce neyi yapayım" olmaktan çıkıp "gerçekten neyin neyi beklemesi gerekiyor" oluyor. Cevap genelde sandığından az.
Prompt yazma şeklin de değişiyor. Düz bir prompt Claude'a sırayla ne yapacağını söylüyor. Graph prompt'u her parçanın neye ihtiyacı olduğunu söylüyor ve sırayı Claude'a bırakıyor. Daha kısa oluyor, düzenlemesi kolaylaşıyor ve tek bir node'u değiştirdiğinde kırılmıyor.
Bu yazıdan tek bir şey alıp uygulayacaksan sahte edge testi olsun. Bu hafta bir workflow'a uygula. Bir tane yeter. Adımları çıkar, okları tek tek sorgula, hangisinin gerçekten veri taşıdığına bak. En az bir tanesinin taşımadığını göreceksin.
Model tam o anda oturuyor. Teoriyi anladığında değil, kendi kurduğun bir şeyde ilk sahte edge'i bulduğunda ve aylardır onu beklediğini fark ettiğinde.
Gerisi buradan geliyor.
fig. 01–05 · blueprint.dark · @omerfrkdemiral